Satu nama dapat terlihat sama di dua layar tetapi gagal ditemukan oleh kotak pencarian. Catatan yang sebelumnya berbunyi “café” berubah menjadi “café” sesudah dipindahkan. Di perangkat lain, emoji yang tadi utuh terbelah menjadi beberapa lambang. Gejalanya mirip karena sama-sama menyangkut teks, tetapi penyebabnya berbeda. Mengetahui perbedaan itu membantu Anda memilih pemeriksaan yang masuk akal sebelum menyimpan ulang berkas atau mengganti isi ribuan baris.
Unicode menyediakan cara bersama untuk mewakili karakter dari berbagai sistem tulisan. UTF-8 adalah salah satu cara menyimpan karakter tersebut sebagai byte. Font kemudian menggambarkannya di layar. Tiga lapisan ini bekerja bersama, tetapi kegagalan pada satu lapisan tidak otomatis berarti dua lainnya rusak. Mulailah dari salinan berkas, catat aplikasi asalnya, dan pisahkan persoalan tampilan dari perubahan data. Bila sedang belajar membaca keluaran aplikasi, pengantar literasi data membantu membiasakan pemeriksaan semacam ini.
Karakter bukan gambar huruf
Huruf yang Anda baca memiliki bentuk visual, sementara komputer memerlukan pengenal untuk mengolahnya. Unicode memberikan titik kode untuk banyak karakter. Sebuah titik kode lazim ditulis dengan awalan U+ diikuti bilangan heksadesimal. Pengenal itu merujuk pada karakter abstrak, bukan potongan gambar dengan bentuk yang selalu persis sama. Huruf a tetap huruf a ketika bentuknya berubah antara jenis huruf serif dan sans serif.
Gambar yang benar-benar tampil disebut glyph. Font memilih gambar berdasarkan karakter dan konteksnya. Beberapa karakter dapat digabung menjadi satu bentuk visual; sebaliknya, satu rangkaian yang tampak sebagai satu simbol bisa tersusun dari beberapa titik kode. Karena itu, menghitung jumlah gambar di layar tidak selalu memberikan jumlah karakter yang diolah sebuah program.
Perbedaan ini berguna saat keluhan berbunyi “hurufnya berbeda”. Bandingkan teks melalui salin-tempel ke aplikasi sederhana dan periksa titik kodenya bila perlu. Jika datanya sama tetapi bentuk berubah ketika font diganti, persoalannya mungkin pada dukungan font atau pembentukan tulisan. Mengetik ulang seluruh dokumen justru menambah peluang salah tanpa memperbaiki penyebab tampilan.
Dari titik kode menjadi byte
Berkas di penyimpanan berisi byte. Agar byte dapat dibaca sebagai teks, aplikasi harus mengetahui pengodeannya. UTF-8 mewakili titik kode Unicode dengan satu sampai empat byte. Karakter ASCII yang umum, seperti huruf Latin dasar dan angka, memakai satu byte dalam UTF-8. Banyak huruf bertanda diakritik dan simbol lainnya memerlukan lebih banyak byte.
Ini menjelaskan mengapa ukuran berkas bukan jumlah huruf. Dokumen dua ribu karakter tidak selalu berukuran dua ribu byte. Tambahan baris, metadata format, dan pengodean juga memengaruhi ukurannya. Batas unggahan yang dinyatakan dalam byte harus diperiksa terhadap berkas yang benar-benar dikirim, bukan diperkirakan dari jumlah karakter di editor.
Ada pula UTF-16 dan UTF-32. Ketiganya dapat mewakili Unicode, tetapi susunan byte dan unit kodenya berbeda. Mengganti ekstensi berkas menjadi .txt tidak mengubah susunan itu. Konversi membutuhkan pembacaan dengan pengodean asal yang benar, lalu penulisan dengan pengodean tujuan. Tanpa langkah pembacaan yang tepat, hasil konversi dapat menyimpan kesalahan sebagai teks baru yang secara teknis sah.
Mengapa tulisan berubah menjadi café
Mojibake adalah sebutan untuk teks yang berubah menjadi rangkaian aneh akibat salah penafsiran pengodean. Contohnya, byte UTF-8 untuk é dibaca menggunakan pengodean lain, lalu ditampilkan sebagai beberapa karakter. Kesalahan itu dapat terjadi ketika berkas dibuka, saat respons jaringan diproses, atau ketika data melewati aplikasi perantara yang membuat asumsi sendiri.
Jangan menyimpulkan bahwa setiap tulisan aneh merupakan kasus yang sama. Tanda tanya bisa memang tersimpan dalam data. Kotak kosong bisa menunjukkan glyph yang tidak tersedia. Simbol pengganti berbentuk wajik dengan tanda tanya berkaitan dengan rangkaian yang tidak berhasil ditafsirkan. Pemeriksaan perlu membedakan byte asli dari gambar yang dipakai aplikasi untuk menjelaskan masalah.
Dalam contoh rekaan, sebuah katalog diekspor dari aplikasi lama lalu dibuka langsung di aplikasi tabel. Nama dengan huruf dasar tampak normal, sehingga kesalahan baru terlihat pada baris beraksen. Langkah yang masuk akal adalah menutup salinan tanpa menimpa, membuka dialog impor, memilih pengodean yang diketahui dari sistem asal, dan memeriksa beberapa baris berisiko. Satu baris yang normal belum cukup untuk menyatakan seluruh berkas pulih.
Pertahankan sumber sebelum mencoba pemulihan
Simpan berkas asli dengan nama yang jelas dan jangan gunakan sebagai tempat percobaan. Buat salinan kerja, catat ukuran, waktu penerimaan, aplikasi pengirim, dan pengodean yang dinyatakan pengirim. Jika tersedia checksum, simpan nilainya bersama catatan. Anda kemudian dapat membedakan perubahan yang disengaja dari perubahan akibat aplikasi membuka dan menyimpan otomatis.
Pilih sedikit contoh yang mewakili variasi isi: huruf beraksen, tanda kutip lengkung, simbol mata uang sebagai teks bila memang ada dalam data, serta tulisan non-Latin. Contoh bukan untuk mengganti seluruh katalog dengan pencarian massal. Fungsinya membantu menilai hipotesis. Pengodean yang membuat satu kata benar tetapi merusak nama lain belum menjadi pilihan yang aman.
Alat pendeteksi pengodean biasanya menghasilkan dugaan, terutama jika teks pendek atau hanya berisi karakter dasar. Cocokkan dugaannya dengan keterangan ekspor dan aplikasi asal. Bila berkas mengandung informasi pribadi, gunakan alat lokal yang sesuai; mengunggahnya ke situs “perbaikan teks” menambah pengungkapan data yang tidak diperlukan untuk sekadar menguji pengodean.
Metadata dan isi harus sepakat
Halaman web dapat menyatakan pengodean melalui header Content-Type dan deklarasi di HTML. Berkas CSV mungkin diproses berdasarkan pilihan impor, informasi aplikasi, atau penanda pada awal berkas. Pernyataan pengodean sebaiknya cocok dengan byte yang dikirim. Menambahkan tulisan UTF-8 pada metadata tidak mengubah isi yang sebelumnya dibuat dengan pengodean berbeda.
Dalam pengembangan, periksa rangkaian dari penyimpanan ke respons: editor menyimpan dengan pengodean apa, pustaka membaca dengan pilihan apa, basis data mengembalikan apa, lalu server mengirim deklarasi apa. Uji satu contoh yang melewati jalur lengkap. Pratinjau lokal yang benar tidak membuktikan bahwa respons server dan proses ekspornya juga menggunakan pilihan yang sama.
Untuk pekerjaan harian, minta format ekspor secara eksplisit. Keterangan “teks biasa UTF-8” lebih berguna daripada “file biasa”. Saat menerima berkas dari sistem lama, catat pengodean asal dalam petunjuk impor. Dokumentasi kecil ini mengurangi ketergantungan pada ingatan seorang operator, terutama ketika berkas harus diproses lagi berbulan-bulan kemudian di perangkat yang berbeda.
Dua e beraksen yang tampak sama
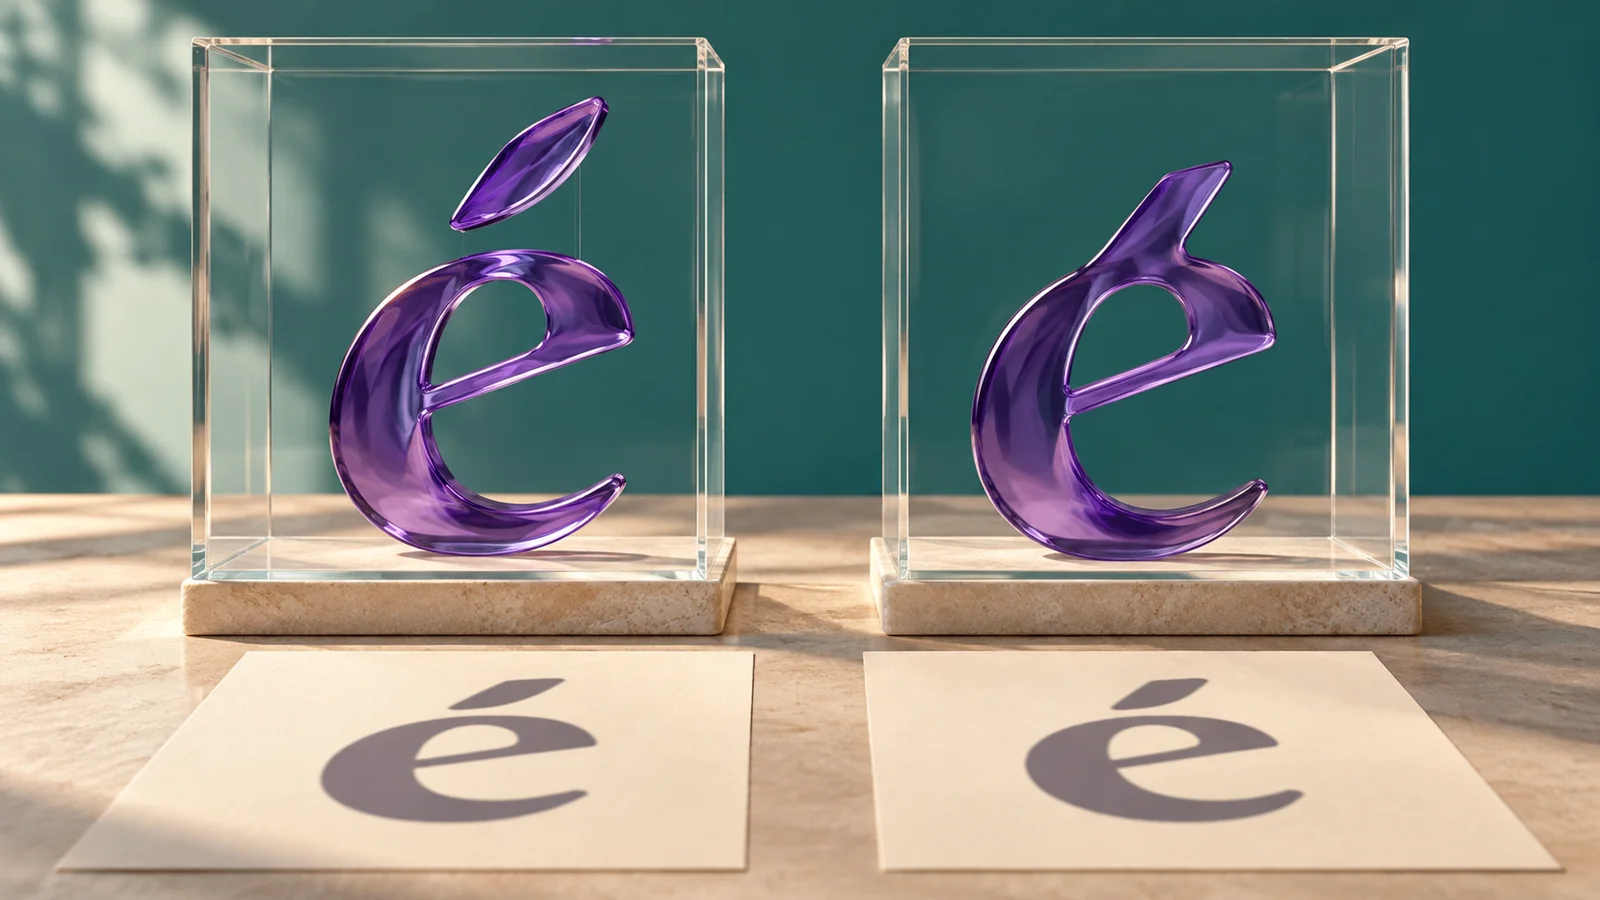
Unicode dapat mewakili beberapa bentuk teks dengan rangkaian yang berbeda tetapi setara secara kanonis. Huruf beraksen tertentu dapat berupa karakter tunggal, atau huruf dasar disusul tanda penggabung. Keduanya mungkin terlihat sama. Namun, perbandingan byte mentah atau perbandingan string yang tidak memperhitungkan normalisasi dapat menilainya berbeda.
Normalisasi memberikan bentuk teratur bagi rangkaian tersebut. NFC menggunakan dekomposisi kanonis kemudian komposisi, sedangkan NFD mempertahankan hasil dekomposisi kanonis. Pilihan bergantung pada kebutuhan dan lingkungan. Untuk pencarian atau pertukaran data, yang penting adalah kebijakan konsisten dan pengujian, bukan keyakinan bahwa bentuk yang lebih pendek selalu lebih benar.
Misalnya, dalam contoh rekaan, dua daftar peserta mengandung nama yang tampak identik. Penggabungan gagal karena representasi aksennya berbeda. Pemeriksa dapat membandingkan titik kode pada salinan, menormalisasi kunci pencarian sesuai kebijakan, lalu mengulang pencocokan. Nama asli tetap disimpan. Dengan begitu, alat memperoleh kunci yang konsisten tanpa mengubah ejaan yang dipilih pemilik nama secara sembarangan.
Normalisasi kompatibilitas perlu tujuan yang jelas
NFKC dan NFKD melibatkan kesetaraan kompatibilitas, yang lebih luas daripada kesetaraan kanonis. Beberapa bentuk tampilan atau karakter khusus dapat dipetakan menjadi bentuk yang lebih umum. Hal ini bermanfaat dalam konteks tertentu, tetapi dapat menghilangkan perbedaan yang ingin dipertahankan pada dokumen, pengenal, atau notasi teknis.
Jangan mengubah seluruh koleksi ke NFKC hanya karena hasil pencarian menjadi lebih rapi. Tentukan apakah data merupakan nama, kutipan, kode produk, rumus, atau teks pencarian. Kebutuhannya berbeda. Kunci pencarian dapat memiliki transformasi terpisah, sementara sumber dan bentuk tampilannya tetap dipertahankan agar pemeriksaan serta pemulihan masih mungkin dilakukan.
Normalisasi juga bukan penerjemahan atau pemeriksaan ejaan. Ia tidak memutuskan bahwa dua nama milik orang yang sama, tidak mengetahui apakah aksen boleh dibuang, dan tidak otomatis menyamakan semua simbol yang mirip. Gabungkan hasilnya dengan aturan bidang data. Jika suatu pengenal harus persis, perubahan otomatis memerlukan alasan yang lebih kuat daripada sekadar kemiripan visual.
Panjang teks bergantung pada pertanyaannya
Pertanyaan “berapa karakter?” perlu diperjelas. Program dapat menghitung byte, unit kode, titik kode, atau gugus grafem yang kira-kira berhubungan dengan satu karakter yang dirasakan pembaca. Hasilnya bisa berbeda, khususnya untuk emoji, tanda penggabung, dan tulisan yang pembentukannya melibatkan rangkaian kompleks.
Dalam JavaScript, misalnya, properti length pada string berkaitan dengan unit kode UTF-16. Angka itu tidak selalu sama dengan jumlah simbol yang terlihat. Ketika membatasi panjang judul, memotong kutipan, atau membuat penghitung masukan, pengembang perlu memilih konsep panjang yang sesuai. Pemotongan mentah pada posisi yang keliru dapat membelah rangkaian dan menghasilkan tampilan yang membingungkan.
Di sisi pengguna, jangan menghapus aksen atau emoji satu per satu hanya untuk memenuhi batas yang tidak dijelaskan. Coba contoh pendek dan lihat pesan aplikasi. Laporkan contoh beserta langkah reproduksinya kepada pengelola, tanpa mengirim data sensitif. Persyaratan yang baik menjelaskan apakah batasnya ukuran unggahan, panjang penyimpanan, atau kenyamanan tampilan, karena ketiganya membutuhkan ukuran berbeda.
Kotak kosong belum berarti data hilang
Jika sebuah perangkat menampilkan kotak kosong, buka teks yang sama menggunakan font dan aplikasi yang mendukung sistem tulisannya. Font dapat kekurangan glyph meskipun titik kode masih tersimpan benar. Dukungan pembentukan tulisan dan versi perangkat lunak juga memengaruhi bagaimana rangkaian karakter digambarkan.
Uji salin-tempel ke lingkungan lain tanpa menyimpan ulang sumber. Bila teks tampil benar di sana, simpan bukti perbandingan dan periksa pengaturan font aplikasi pertama. Jangan mengganti kotak dengan spasi pada dokumen asli: tindakan itu menghilangkan informasi yang sebenarnya mungkin masih utuh. Ekspor ke gambar juga menutupi gejala tanpa memperbaiki teks yang dibutuhkan untuk pencarian dan aksesibilitas.
Sebaliknya, jika isi sumber memang sudah berupa tanda tanya, mengganti font tidak akan mengembalikan karakter sebelumnya. Pemulihan memerlukan salinan yang lebih awal atau sumber lain yang dapat dipercaya. Batas ini perlu diakui sejak awal agar upaya perbaikan tidak berubah menjadi menebak nama, angka, atau kutipan yang semestinya diperoleh dari bukti.
Spasi yang terlihat sama dapat berperilaku berbeda
Teks dapat mengandung spasi biasa, spasi tanpa pemutusan baris, dan karakter pengaturan lain. Saat disalin dari halaman web atau PDF, karakter semacam ini ikut berpindah. Akibatnya, pencarian persis gagal, baris tidak terbungkus seperti yang diharapkan, atau pengenal yang terlihat sama ditolak oleh formulir.
Gunakan fitur menampilkan karakter tak terlihat pada editor jika tersedia. Periksa satu contoh, bukan langsung mengganti seluruh karakter yang tidak dikenal. Spasi tanpa pemutusan mungkin sengaja menjaga angka dengan satuannya. Tanda pengarah tulisan dapat diperlukan untuk tampilan campuran. Menghapus semuanya sekaligus bisa memperbaiki satu gejala sambil merusak bagian lain.
Untuk data terstruktur, tentukan kebijakan per kolom. Pengenal mesin mungkin hanya menerima himpunan karakter terbatas; kolom nama membutuhkan dukungan jauh lebih luas. Normalisasi spasi pada kunci pencarian tidak harus menimpa teks asli. Catat transformasi dan sediakan cara meninjau perubahan, terutama bila hasilnya akan dipakai mencocokkan identitas atau menggabungkan catatan.
Kemiripan bentuk bukan bukti kesamaan
Dua karakter dari sistem tulisan berbeda dapat tampak mirip. Huruf Latin dan huruf dari alfabet lain bisa menghasilkan kata yang sekilas sama tetapi memiliki titik kode berbeda. Unicode tidak membuat semuanya menjadi karakter tunggal, karena karakter tersebut memiliki penggunaan dan sejarah tersendiri.
Untuk tautan, alamat, atau pengenal penting, kemiripan visual perlu diperlakukan hati-hati. Buka tujuan melalui jalur yang sudah diketahui bila ragu. Jangan membuat aturan bahwa semua tulisan non-Latin mencurigakan; masalahnya terletak pada penyamaran dalam konteks pengenal tertentu, bukan pada sistem tulisan itu sendiri. Pembahasan dasar keamanan siber memberi konteks pemeriksaan tujuan dan permintaan yang tidak wajar.
Normalisasi Unicode biasa juga tidak dapat diandalkan untuk menangkap seluruh karakter yang membingungkan. Pengelola sistem perlu aturan pengenal, penilaian risiko, dan tampilan yang membantu pengguna membedakan tujuan. Untuk dokumen biasa, pertahankan ejaan asli dan hindari mengganti karakter hanya karena terlihat asing. Koreksi seharusnya berdasarkan sumber yang sah, bukan dugaan dari bentuk font.
Sebelum mengirim laporan, sertakan cuplikan yang cukup untuk reproduksi dengan data rekaan. Catatan seperti “karakter rusak” terlalu luas. Lebih berguna menyebut bahwa berkas UTF-8 menampilkan aksen dengan benar di editor, tetapi berubah setelah impor menggunakan pilihan tertentu. Simpan juga keluaran mentah yang belum disunting. Pengelola kemudian dapat memeriksa asumsi pada tahap yang tepat tanpa perlu menerima seluruh dokumen pribadi Anda.
Uji perpindahan, bukan hanya hasil di editor
Rancang berkas contoh kecil yang mengandung variasi karakter yang memang digunakan. Sertakan baris dengan aksen, tanda kutip, pemisah baris, dan tulisan lain yang relevan. Catat teks yang diharapkan serta pengodeannya. Tujuannya membangun contoh yang mudah diperiksa, bukan memasukkan setiap karakter Unicode ke satu berkas.
Lalui jalur pekerjaan yang sebenarnya: ekspor, simpan, kirim, impor, proses, lalu ekspor lagi. Bandingkan isi semantik dan byte sesuai kebutuhan. Perubahan akhir baris mungkin disengaja, sedangkan perubahan nama bukan. Keterangan hasil uji harus menyebut aplikasi, versi, pilihan impor, dan tahap yang pertama kali menghasilkan perbedaan.
Dalam contoh rekaan sebuah perpustakaan kecil, masalah muncul hanya setelah data masuk ke aplikasi laporan. Berkas awal dan impor basis datanya benar. Dengan menguji tiap perpindahan, petugas menemukan bahwa ekspor laporan memakai pengodean lama. Mengubah pengaturan pada tahap itu menyelesaikan penyebabnya; mengganti seluruh katalog ke karakter tanpa aksen justru akan mengurangi ketepatan informasi.
Jika perbaikan otomatis menghasilkan banyak perubahan
Tinjau jumlah serta jenis perubahan sebelum menyetujui hasil. Apakah semua perubahan berhubungan dengan gejala yang diperiksa? Apakah angka, URL, tanda baca, atau nama ikut berubah? Bandingkan beberapa contoh dari awal, tengah, dan akhir berkas, serta baris yang paling berisiko. Perbedaan dapat dibaca sebagai teks, bukan hanya persentase keberhasilan alat.
Pisahkan deteksi dari penulisan. Jalankan laporan calon perubahan terlebih dahulu, simpan keluaran baru di lokasi berbeda, lalu periksa hasilnya. Jika ada bagian yang ambigu, tandai untuk peninjauan daripada menebak. Bekerja pada kumpulan kecil membuat penjelasan dan pemulihan lebih mudah ketika asumsi awal ternyata keliru.
Catat metode yang akhirnya dipilih: pengodean asal, pengodean tujuan, normalisasi jika ada, dan pengecualian. Simpan sumber serta hasil sampai pemilik data menyatakan pemeriksaan selesai. Checksum SHA-256 dapat membantu membuktikan berkas mana yang dibahas dalam catatan itu, meskipun checksum sendiri tidak menilai apakah teksnya sudah benar bagi pembaca.
Byte order mark dan berkas yang tampak kosong di awal
Sebagian berkas diawali byte order mark, sering disingkat BOM. Dalam beberapa bentuk pengodean, penanda ini membantu mengidentifikasi urutan byte. Pada UTF-8, urutan byte tidak memiliki pilihan besar-kecil seperti pada UTF-16, tetapi penanda UTF-8 tetap dapat ditemui sebagai tanda pengenal. Penerima berkas tidak selalu memperlakukannya dengan cara yang sama.
Gejala yang mungkin muncul adalah nama kolom pertama gagal dikenali walaupun tampak benar. Parser tertentu dapat mempertahankan penanda itu sebagai bagian awal teks jika tidak menangani BOM sesuai kebutuhan. Operator lalu mengira ada salah ejaan pada judul kolom. Pemeriksaan byte awal atau tampilan karakter tersembunyi dapat menjelaskan mengapa pencocokan persis gagal pada satu kolom saja.
Jangan menghapus tiga byte pertama setiap berkas secara membabi buta. Pastikan byte tersebut memang penanda UTF-8, bukan bagian isi sah atau format lain. Tentukan apakah aplikasi tujuan mengharapkan UTF-8 dengan BOM atau tanpanya, lalu ekspor ulang pada salinan. Catat pilihan tersebut dalam petunjuk pertukaran data. Untuk CSV, keputusan mengenai BOM perlu dilihat bersama pemisah kolom, tanda kutip, dan pengaturan impor, bukan sebagai obat tunggal untuk semua kesalahan tabel.
Tangani kesalahan pembacaan secara terlihat
Pustaka pemrosesan teks dapat menyediakan pilihan berbeda ketika menemukan byte tidak sah. Ada yang menghentikan pembacaan, mengganti bagian bermasalah dengan karakter pengganti, atau mengabaikannya. Pilihan terakhir tampak nyaman karena proses tetap selesai, tetapi dapat menghapus bagian nama atau menggabungkan dua nilai yang tadinya berbeda.
Pada data penting, kegagalan yang jelas sering lebih membantu daripada keluaran yang terlihat bersih namun kehilangan informasi. Simpan nomor baris atau posisi byte yang gagal, sepanjang pencatatan itu tidak membocorkan isi sensitif. Pisahkan baris bermasalah untuk pemeriksaan, sementara sumber lengkap tetap terlindungi. Penyelesaian proses bukan ukuran tunggal keberhasilan jika sistem menyembunyikan bagian yang tidak terbaca.
Dalam contoh rekaan, impor daftar judul menelan karakter pengganti lalu membuangnya. Dua judul berbeda menjadi identik sehingga aturan deduplikasi menghapus salah satunya. Masalah awalnya bukan aturan deduplikasi, melainkan pembacaan yang menghilangkan karakter tanpa pelaporan. Uji yang memasukkan contoh byte tidak sah akan menunjukkan perilaku itu sebelum koleksi besar diproses. Dokumentasikan apakah sistem menolak, mengganti, atau menandai masukan bermasalah, lalu sesuaikan langkah manusia untuk memeriksanya.
Bedakan pencarian ramah pengguna dari penyimpanan asli
Pencarian kadang sengaja mengabaikan perbedaan huruf besar, aksen, atau variasi spasi agar hasil lebih mudah ditemukan. Itu merupakan pilihan produk yang perlu dijelaskan. Teks sumber tetap dapat disimpan apa adanya, sedangkan indeks pencarian memakai bentuk turunan. Pemisahan tersebut menjaga kutipan dan ejaan asli tanpa memaksa pengguna mengetahui semua rincian representasinya.
Tetapkan pula apa yang ditampilkan ketika beberapa hasil cocok dengan kunci yang sama. Jangan langsung menggabungkannya menjadi satu identitas. Nama yang berbeda bisa berubah menjadi kunci pencarian identik setelah aksen atau tanda baca dihilangkan. Sistem perlu menampilkan rincian pembeda yang sah, bukan menganggap kecocokan longgar sebagai bukti bahwa dua catatan boleh disatukan.
Untuk memeriksa kebijakan itu, susun pasangan contoh: berbeda hanya pada bentuk normalisasi, berbeda pada aksen yang bermakna, berbeda pada huruf besar, dan berbeda pada karakter yang sekilas mirip. Tentukan hasil yang diharapkan untuk masing-masing. Pengujian yang konkret membantu pengelola menjelaskan mengapa satu pencarian fleksibel sementara pemeriksaan pengenal harus ketat. Hasilnya adalah perilaku yang dapat dinilai dan diperbaiki, bukan rangkaian transformasi tersembunyi yang sulit ditelusuri ketika pengguna menemukan kejanggalan.
Normalisasi bukan mengubah alfabet
Periksa istilah yang dipakai alat. Normalisasi Unicode, perubahan kapitalisasi, transliterasi, dan pembuangan aksen merupakan operasi berbeda. Alat yang menamainya semua sebagai “bersihkan teks” dapat menyembunyikan perubahan yang bermakna. Sebelum menyetujui hasil, lihat contoh sebelum dan sesudah serta tanyakan aturan mana yang dijalankan.
Misalnya, pencarian bisa memakai kunci tanpa aksen untuk membantu menemukan variasi, tetapi kutipan bahasa aslinya tetap perlu mempertahankan aksen tersebut. Menyimpan keduanya sebagai bidang berbeda membuat tujuannya jelas. Jika perangkat lunak tidak menjelaskan transformasinya, uji pada salinan pendek dengan beberapa pasangan karakter yang diketahui. Jangan menyimpulkan bahwa teks telah dipertahankan hanya karena seluruh huruf kini dapat ditampilkan oleh font paling sederhana.
Pilih perbaikan yang menjaga informasi
Bila masalah hanya font, perbaiki lingkungan tampilan. Bila metadata keliru, selaraskan deklarasi dengan byte yang benar. Bila pembacaan salah tetapi byte asli masih ada, lakukan konversi dari sumber yang terjaga. Bila karakter sudah digantikan dan sumber lama hilang, akui bahwa informasi tertentu mungkin tidak dapat dipulihkan dengan kepastian.
Kebiasaan memakai UTF-8 secara konsisten membantu pertukaran teks modern, tetapi tetap membutuhkan kebijakan impor, pengujian, dan penanganan kesalahan. Nama berkas, ekstensi, dan tampilan pratinjau tidak cukup menjadi bukti. Pilihan yang baik mempertahankan sumber serta menjelaskan transformasi sehingga orang lain dapat mengulang pemeriksaan tanpa bergantung pada tebakan.
Saat gejala muncul kembali, pertanyaan pertama yang berguna adalah “pada perpindahan mana data berubah?” Jawabannya mengarahkan pemeriksaan ke tempat yang tepat. Dengan memisahkan karakter, byte, normalisasi, dan font, Anda dapat menyelesaikan banyak masalah teks secara lebih tenang serta menghindari tindakan massal yang justru menghapus informasi yang hendak diselamatkan.
Pertanyaan yang sering muncul
Apakah UTF-8 sama dengan Unicode?
Unicode menetapkan karakter dan titik kode; UTF-8 merupakan salah satu bentuk pengodeannya menjadi byte. Font menentukan bentuk visual yang ditampilkan.
Apakah mengganti font memperbaiki teks yang salah pengodean?
Font membantu bila glyph tidak tersedia. Bila byte telah dibaca keliru atau karakter sudah diganti dalam data, perlu memeriksa sumber dan pengodeannya.
Bolehkah semua teks langsung dinormalisasi ke NFKC?
Tentukan tujuannya dahulu. Normalisasi kompatibilitas dapat menghilangkan perbedaan yang dibutuhkan. Pertahankan sumber dan uji transformasi pada salinan.
Bagaimana memulai pemeriksaan teks yang rusak?
Simpan sumber, buat salinan, catat aplikasi serta pengodean asal, lalu cari tahap pertama ketika representasi berubah. Jangan menimpa satu-satunya sumber.